给经典 Mac 模拟器加存档:Asyncify、虚拟时钟与"磁盘忙"
2026 年 10 月 2 日 · 模拟器 · WebAssembly · Asyncify · 经典 Mac
上一篇讲了 Webulator 想做的事:页面上的一张截图,点一下就原地变成一台正在运行的电脑。这要求每台机器都能存档,并且能在一个全新的页面里恢复,第一帧和存档时完全一样。
x86 这边的 v86 自带 save_state()。麻烦在 Mac:我用的三个经典 Mac 模拟器(Mini vMac、Basilisk II、SheepShaver,都是 Infinite Mac 项目的 Emscripten 构建)都没有存档功能。如果这件事做不成,Mac 一侧的”秒醒”就得重新设计,所以它是整个计划里风险最高的一项,我最先做的就是它。
这篇是那次实验的记录。测试机是 Apple M2,无头 Chromium 153,Emscripten 4.0.22。
为什么不能直接把内存存下来
Emscripten 编出来的模拟器,客户机的一切(内存、CPU 寄存器、设备状态)都在 wasm 的线性内存里。看起来把这块内存复制出来、换个实例写回去就行了。
问题在于这三个模拟器的主循环是阻塞的:main() 一进去就再也不返回 JS,模拟器需要输入时,从 C++ 里通过 EM_ASM 回调一个全局的 workerApi 对象。而 wasm 的调用栈不在线性内存里。你可以在回调里随时复制出整块内存,但新实例拿到这块内存,并不知道该从哪一层函数、哪一行继续执行。
读源码后我列了两个方案:
- 方案 A,只改编译参数:打开 Emscripten 的 Asyncify,但只插桩很窄的一条调用路径。在回调处把调用栈展开(unwind)到线性内存里,存档;新实例里再回卷(rewind)回去。不碰源码,但要测插桩带来的性能损失。
- 方案 B,打源码补丁:导出一个
resume(),跳过初始化直接重新进入 CPU 循环。我估计 Mini vMac 要 30 到 60 行,Basilisk II 50 到 100 行,SheepShaver 80 到 150 行(它有嵌套的执行深度和 68k/PPC 模式切换)。
先试 A。
Asyncify:只插桩一条路径
Asyncify 是 Emscripten 的一个编译变换:被插桩的函数可以把自己的局部变量和执行位置存进线性内存里的一块缓冲区,然后一层层返回(展开);之后再被调用时,按缓冲区里的记录一层层走回原来的位置(回卷)。它本来是用来让同步的 C 代码等待异步 JS 的,但它恰好解决了”调用栈不在内存里”的问题:展开之后,整台机器就全在线性内存里了。
全量 Asyncify 会插桩所有可能调用到 JS 的函数,代价很大。我只需要一条路径:从 main 到轮询输入的那个回调。Mini vMac 这条路径是:
main → ProgramMain → MainEventLoop → WaitForNextTick → ReadJSInput编译参数就是这些:
-sASYNCIFY
-sASYNCIFY_IMPORTS=["env.emscripten_asm_const_int"]
-sASYNCIFY_ONLY=["main", …, "ProgramMain", "MainEventLoop", "WaitForNextTick", "ReadJSInput"]
ASYNCIFY_IMPORTS 告诉 Asyncify:EM_ASM 这个导入(也就是回调 workerApi 的地方)可能会让栈展开。CPU 核心本身不在名单里,没有被插桩,所以速度不变。另外加了一段 9 行的 --pre-js,把 Asyncify 对象、wasm 导出和读写栈指针的函数暴露给宿主的 JS。
存档
页面想存档时,在 SharedArrayBuffer 里置一个标志位。模拟器每个 tick 都会调用一次 workerApi.acquireInputLock 来取输入,宿主就在这里检查标志:
acquireInputLock() {
  const A = asyncify();
  if (A && A.state === REWINDING) return A.handleSleep(() => {});   // 回卷结束
  const { snapshot } = env.poll(true);
  if (snapshot && A && atSafePoint()) {
    return A.handleSleep(wake => {
      setTimeout(() => {   // 这时 wasm 栈已经展开,整台机器都在线性内存里
        env.sendSnapshot(captureCore(A));
        wake(0);
      }, 0);
    });
  }
  return stageInput();
}
Asyncify.handleSleep 让调用栈展开到线性内存,Worker 回到自己的事件循环。这时复制四样东西就够了:整块 wasm 内存、栈指针、Asyncify 数据缓冲区的地址、以及回卷时要重新进入的那个导出函数。磁盘的写入另外按 4 KB 一块记录,只存写过的块;这次 Mini vMac 只写了 1 块。存完调用 wake(0),原来的机器接着跑。
恢复
新的 Worker 用 noInitialRun 实例化模块(运行时起来了,但不调用 main),然后:
- 把内存整块写回去;
- 恢复栈指针;
- 重建 Asyncify 在 JS 侧的回卷表:新实例的表是空的,按存档里记录的导出函数名,把回卷 id 映射回对应的函数;
- 调用
asyncify_start_rewind和doRewind。
模拟器重新进入 main,沿着存下来的调用栈一路回卷到输入轮询处,然后继续运行,就好像什么都没发生过。基础磁盘镜像单独加载(它是共享的,可以长期缓存),写过的块叠加在上面。
第一帧不用等模拟器重画:存档时记下了帧缓冲在线性内存里的地址,内存一写回,直接从那个地址读出画面就是第一帧。
Mini vMac:成了
| 源码改动 | 无 |
| 编译改动 | Asyncify 只插 5 个外层循环函数,外加 9 行 --pre-js |
| wasm 体积 | 264,457 → 275,480 字节(+4%) |
| 开机到 Finder(10 次中位数) | 不带 Asyncify 0.487 s,带 Asyncify 0.463 s(测不出变慢) |
| 存档(请求到拿到快照) | 27 到 63 ms(展开 2 到 4 ms,复制内存 17 到 43 ms) |
| 快照文件 | 原始 48.0 MB;gzip 562 KB,zstd -3 441 KB,zstd -19 327 KB |
| 新页面恢复(Worker 启动到第一帧,5 次中位数) | 37 ms(原始文件),39 ms(gzip) |
| 第一帧与存档画面 | 10 次全部 0 像素差 |
| 恢复后能否使用 | 10 次全部能打开苹果菜单、打开计算器 |
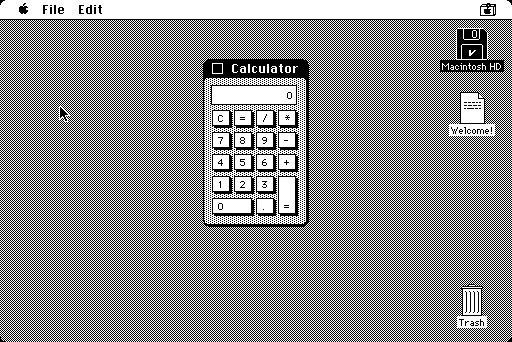
一台 Mac Plus 在一个 Worker 里存档,在另一个刚刷新的页面里的全新 Worker 中恢复,继续运行。没有改一行模拟器源码。
快照原始大小是 48 MB,这个数字来自 INITIAL_MEMORY(构建脚本里写的是 50331648 字节),绝大部分是零,所以压缩后只剩几百 KB。真正走网络的是压缩后的大小。
快照和构建是绑死的:内存布局和回卷 id 必须完全对上。所以 Webulator 在每个快照里记录核心 wasm 的哈希,构建不同就拒绝恢复。
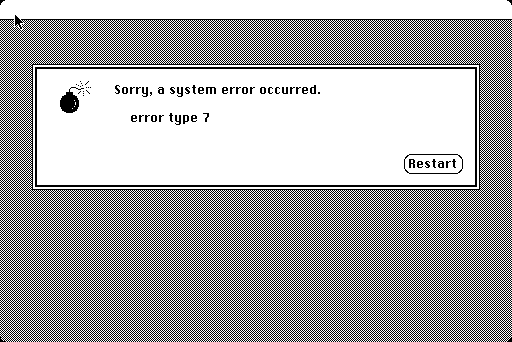
顺带一个没解决的小问题:Mini vMac 只能用 -O0 编译。-O1、-O2、-O3 下,不管带不带 Asyncify,System 6 开机就弹炸弹(“error type 7”)。加 -fno-strict-aliasing -fwrapv 也没用。Infinite Mac 发布的也是 -O0 构建。很可能是 CPU 核心里有未定义行为,和存档无关,我没有继续追。
Basilisk II:嵌套的 CPU 循环
Basilisk II(Quadra 650,68040,32 MB 客户机内存,System 7.5.3)按 Infinite Mac 的方式用 -O3 编译。同样的宿主代码,同样没改源码,只插 3 个函数:main、m68k_execute()、ReadJSInput(long long)。
| 原版 | 全量 Asyncify | 只插 3 个函数 | |
|---|---|---|---|
| wasm 体积 | 1,713,959 | 2,552,713(+49%) | 1,747,136(+2%) |
| 开机到桌面稳定(中位数) | 1.48 s | 1.66 s(+12%) | 1.47 s(不变) |
这里对比得很清楚:全量 Asyncify 体积多一半、速度慢 12%;只插一条路径,几乎没有代价。
快照大小主要由 INITIAL_MEMORY 决定。Infinite Mac 默认给 288 MB,对 32 MB 的客户机来说太多了。改成 80 MB 后,gzip 从 2.2 MB 降到 2.0 MB,新页面从 gzip 文件恢复到第一帧 157 ms(取文件 10 ms,解压 51 ms,恢复 79 ms)。
Basilisk II 带来一个新问题:CPU 循环会嵌套。原生代码需要调用 68k 代码时(Execute68k),会再进一次 m68k_execute。Asyncify 只插桩了外层路径,嵌套的那几层展不开。我的做法是在宿主里看 JS 的调用栈:m68k_execute 必须恰好出现一次,否则这次不存,推迟到下一次输入轮询。实际在空闲的桌面上一次都没推迟过。
虚拟时钟:缺了它,恢复后慢到秒级
Basilisk II 还暴露了一个更隐蔽的问题。快照刚存下就恢复,一切正常;放一分钟以上再恢复,机器就变得极慢:打开计算器要 5 到 8 秒,正常是 15 ms 左右。
原因在 main_unix.cpp 的 cpu_do_check_ticks。Basilisk II 大约每 166 ms 重新校准一次”两次检查时钟之间跑多少条指令”,算法是”指令数 / 经过的时间”。存档和恢复之间的空白被算成了经过的时间,于是这个配额塌到接近 0,模拟器几乎每条指令都去查一次时钟。
修法不用改源码。Emscripten 的所有时间导入(emscripten_date_now、emscripten_get_now、clock_time_get)最后都调用 Date.now 和 performance.now,所以在 Worker 里加载任何核心代码之前,先把这两个函数换掉:
export const realDate = Date.now.bind(Date);
export const realPerf = performance.now.bind(performance);

let offDate = realDate() - realPerf();   // 客户机日期 = realPerf() + offDate
let offPerf = 0;                         // 客户机 perf = realPerf() + offPerf
let frozenAt: number | null = null;

const nowReal = () => (frozenAt ?? realPerf());
export const guestDate = () => nowReal() + offDate;
export const guestPerf = () => nowReal() + offPerf;

Date.now = guestDate;
performance.now = guestPerf;
暂停时记下暂停的时刻,继续时把暂停的时长从偏移里扣掉;存档时把两个时钟的当前值写进快照;恢复时把偏移设成”存档时的值减去现在的真实时间”。客户机看到的时间 = 起始时刻 + 实际运行时长,暂停和存档到恢复之间的空白都看不到。
同一份放了 90 秒的快照:带虚拟时钟时打开计算器 12 到 23 ms,不带时 5.7 到 7.7 s。
这件事让”暂停时冻结客户机时钟”从一条整洁性要求变成了正确性要求。Mini vMac 的表现不一样:恢复后它看到一个很大的时间跳变,当作”模拟被中断”直接跳过(OSGLUESC.c 的 UpdateTrueEmulatedTime),Mac 的日期则跳到宿主的当前日期。经典 Mac 的时钟还有一个特点:暂停后不补 tick,但每秒都从宿主重读一次日期,到期的 Time Manager 任务会马上触发。所以三个 Mac 核心都用同一个虚拟时钟。v86 也一样:它的 microtick 在模块加载时就绑定了 performance.now,所以替换必须发生在加载之前。
SheepShaver:15% 的代价
SheepShaver(Power Macintosh 9500 ROM,64 MB 客户机内存,System 7.5.3 PPC)和 Basilisk II 共用同一套 JS 胶水代码,宿主不用改。插 4 个函数:main、powerpc_cpu::execute(unsigned int)、CheckTicks()、ReadJSInput(long long)。存档 60 秒后在新页面恢复,5 次首帧全部一致,苹果菜单和计算器都能用,同样没改源码。
| 原版 | 全量 Asyncify | 只插 4 个函数 | |
|---|---|---|---|
| wasm 体积 | 715,546 | 810,946(+13%) | 718,964(+0.5%) |
| 开机到桌面稳定(中位数) | 8.04 s | 9.46 s | 9.34 s(+16%) |
这次有了实实在在的速度损失,大约 15%。原因是 SheepShaver 在 CheckTicks() 里轮询输入,而 CheckTicks() 是从 PPC 解释器主循环 powerpc_cpu::execute 里面调用的。这个函数永远在栈上,必须插桩,而插桩最热的循环就要付出速度。Basilisk II 和 Mini vMac 被插桩的函数都在逐指令路径之外,所以没有代价。如果以后这 15% 真的成了问题,可以打一个小补丁,让 execute 每执行 N 条指令就返回外层一次,只插桩外层循环。目前我选择接受。
SheepShaver 还有两条进入 JS 的路径:空闲时从 execute_sheep → idle_wait → ReadJSInput 轮询输入,以及 CPU 循环通过 execute_macos_code、interrupt、execute_68k 重入自己。所以安全点的判断改成按模拟器配置:栈上 CPU 循环恰好出现一次,并且不出现名单里的帧(SheepShaver 是 execute_sheep|idle_wait,Basilisk II 是 idle_wait,Mini vMac 没有)。空闲桌面上同样一次都没推迟过。
Mac OS 9.0.4(New World ROM)也测了。冷启动到 Finder 稳定要 21 到 25 秒;存档 89 ms;恢复后打开计算器 12 ms,0.73 到 0.83 秒画完,和冷启动后(0.67 到 0.74 秒,主要是窗口打开动画)一样。Worker 内部恢复本身只要 58 到 81 ms。
快照有多大
| profile | 原始 | gzip | zstd -19 |
|---|---|---|---|
| Mini vMac · System 6.0.8 | 48 MB | 562 KB | 327 KB |
| Basilisk II · System 7.5.3(32 MB 客户机内存) | 80 MB | 2.0 MB | 1.65 MB |
| SheepShaver · System 7.5.3 PPC(64 MB) | 128 MB | 6.4 MB | 4.8 MB |
| SheepShaver · Mac OS 9.0.4(64 MB) | 128 MB | 11.4 MB | 8.4 MB |
原始大小就是整块 wasm 内存,大部分是零。zstd 比 gzip 小 15% 到 35%,但浏览器要额外带一个 wasm 解码器;gzip 可以直接用浏览器原生的 DecompressionStream。所以 Webulator 的快照容器里每一段(核心内存、磁盘覆盖层、最后一帧)都用 gzip。一致性测试里,System 6、System 7.5、Mac OS 9 三台桌面快照的容器分别是 0.57、2.0、11.1 MB。
“磁盘忙”:这里我还是改了源码
到这里,存档这件事确实一行源码没改。但把磁盘镜像挪到对象存储上以后,出现了另一个问题,这次绕不过去。
磁盘镜像切成 256 KB 的块放在对象存储上,按需读取,每块大约 0.4 到 0.5 秒。最初的实现在核心线程里用同步 XHR 取块,取块期间整台客户机停住。经典 Mac 的光标是客户机自己画的,所以鼠标也跟着冻住。冷缓存下,一操作就明显卡顿。
真机不是这样的:磁盘忙的时候 CPU 照常运行、照常处理中断,光标照常动。我想要的就是这个行为。
运行时这一侧比较直接:块设备多了一个 ready(offset, length),核心读盘之前先问;数据没到就交给一个后台取块 Worker(8 个 1 MB 的槽位)。难点在于 Mac 核心的线程从不回到事件循环,收不到消息。所以取块 Worker 把数据直接写进 SharedArrayBuffer,再用 Atomics.notify 唤醒核心线程可能正在进行的空闲等待;核心线程在下一次轮询或 ready() 里把完成的块收走。
模拟器这一侧,需要让客户机的磁盘驱动在”数据还没到”时说”忙,等会儿再来”。Basilisk II 和 SheepShaver 共用一份 disk.cpp:DiskPrime 先调用 Sys_ready,数据没到就返回 1。光改这里不够,还得让客户机重试。这两个模拟器的磁盘驱动是一小段写在 ROM 补丁里的 68k 代码,Prime 入口调用模拟器之后直接跳回 IOReturn。我在中间插了两条指令:
Prime:
    M68K_EMUL_OP_DISK_PRIME
    cmp.w   #1,d0       ; 1 = 数据还没取到
    beq.s   Prime       ; 重试,两次之间照常响应中断
    bra     IOReturn
驱动后面几个入口的偏移跟着改了一下。Mini vMac 的 .Sony 驱动是同样的思路,换了一种放法:为了不让驱动里任何东西挪位置,我把带重试的 Prime 追加在驱动后面那段调用块之后,再把原来的 Prime 入口改成一条跳过去的 bra.w。
两份补丁文件一共 211 行(包括上下文),这是三个 Mac 核心身上唯一的源码补丁。
效果用一项新测试来卡:一致性测试 T12。每次取块都人为加 400 ms 延迟,缓存为空,从桌面快照恢复,指针以 60 Hz 画圆,同时执行读盘操作(Mac 上是从苹果菜单打开四个项目),统计帧间隔。至少要取 3 次块,并且帧间隔不能达到 200 ms。
打补丁之前,三个 Mac 核心在这项测试里的最长帧间隔是 416 到 836 ms:每取一次块,客户机就站着不动。打补丁之后:
| profile | 取块次数 | 最长帧间隔 |
|---|---|---|
| Mini vMac · System 6.0.8 | 4 | 33 ms |
| Basilisk II · System 7.5.3 | 18 | 37 ms |
| SheepShaver · Mac OS 9.0.4 | 28 | 59 ms |
这个改法和存档也相处得很好。磁盘请求还没完成时存档,等待中的请求不过是客户机里的一个重试循环,恢复之后自然会重新发起,Mac 核心这边什么都不用特殊处理。
鼠标为什么发黏
最后一个和 Mac 核心有关的问题出在 SheepShaver 的空闲路径上。Mac OS 9 里悬停移动鼠标时只有 7 帧每秒,延迟中位数 303 ms,但拖动时很顺。
SheepShaver 每 5 万条指令才检查一次 60 Hz 的 tick,而 tick 驱动屏幕刷新和光标。客户机空闲时会调用宿主的 idleWait,宿主每次最多阻塞 8 ms,于是 tick 被拖到大约 160 ms 一次。拖动时客户机在忙,不走空闲路径,所以不卡。
改法是让空闲等待只等到下一次刷新到期为止(Infinite Mac 也是这么做的):
idleWait() {
  env.poll(true, false);
  const wait = Math.min(8, lastBlit + 16.7 - performance.now() - 1);
  if (wait > 0) env.idle(wait);
  return env.hasInput() ? 1 : 0;
}
另外,所有核心的出帧下限从 16 ms 降到 12 ms:客户机大约 60 Hz 刷新但有抖动,16 ms 的下限会把每一个稍早到的帧推到下一个周期,看起来就是光标一顿一顿的。改完以后 SheepShaver 悬停时 46 帧每秒,延迟中位数 35 ms。
小结
- 先问调用栈在哪。 阻塞式主循环的模拟器存不了档,不是因为内存拿不到,而是因为调用栈不在内存里。Asyncify 只插桩从
main到输入轮询的那一条路径,就能把栈搬进内存。 - 插桩的位置决定代价。 被插桩的函数在逐指令路径之外,代价几乎为零(Mini vMac、Basilisk II);在解释器主循环里,就要付 15%(SheepShaver)。
- 时间也是状态。 不只是内存和磁盘,客户机感知到的时间也要存档。不然 Basilisk II 恢复后会把空白当成运行时间,把自己调慢到秒级。
- 磁盘忙应该像真机一样。 让驱动说”忙”、让客户机重试,比在宿主里阻塞好得多,而且和存档天然兼容。这是唯一需要碰源码的地方,补丁很小。
还没做的:同一个系统的所有展品可以共享一个开机快照,每个展品只存和它不同的内存页,这样 Mac OS 9 那 11 MB 应该还能小很多。这个留到下一版。